Соберёте на Kubernetes платформу, на которой агенты десятков команд работают в одном кластере и не мешают друг другу. Без неё агент поддержки достаёт до базы биллинга, а ночной пакет одной команды забирает лимит провайдера. В 91 лабораторной вы строите изоляцию исполнения, квоты команд, оператор на Go и общий шлюз моделей. Свой кластер, ключи провайдеров и видеокарты не нужны: песочница курса даёт Kubernetes 1.35, PostgreSQL, Redis и NATS, а провайдеры моделей и GPU в ней эмулируются.
Пока сетевых политик нет, агент поддержки ходит в базу биллинга соседней команды. Исполнитель инструментов запускает скрипт, который прислала модель, и в том же поде лежит смонтированный токен API-сервера. Ночной пакет одной команды выбирает лимит TPM на общем ключе организации, и агенты остальных стоят в очереди.
Привычные очереди не рассчитаны на долгий шаг. Шлюз моделей отвечает от 20 до 50 секунд, а consumer в JetStream с AckWait 15 секунд без продления считает воркер потерянным и отдаёт ту же задачу снова. Каждая копия заново платит за токены и вызывает инструменты. Упавший раннер тоже начинает прогон с нуля и второй раз создаёт тикеты и письма.
Дальше идут инциденты. Агент уходит в цикл: каждый ответ модели ставит в общую очередь новую задачу, и расход на шлюзе растёт каждую секунду. Ключ агента всплывает в публичном логе сборки. MCP-сервер уже после подключения меняет описание инструмента и прячет в нём инструкцию для модели. На каждый из этих случаев в курсе есть лабораторная.
Одна команда решает всё сама: где хранить ключ, как ограничить сеть, кто остановит агента ночью. Когда команд много, у каждой свои ответы, а кластер и лимит провайдера общие. В условном примере курса 20 команд со 140 агентами держат 60 ключей трёх провайдеров в 20 хранилищах. Через шлюз платформы ключей три, и меняют их в одном месте.
В центре курса **оператор ресурса Agent**: команда описывает агента одним объектом, а ServiceAccount, рабочую нагрузку и сетевую политику создаёт оператор. Правила CEL прямо в API-сервере отклоняют scheduled-агента без расписания, смену команды-владельца и рост бюджета в сто раз одним изменением. Оператор возвращает то, что дежурный поправил руками, и не спорит с автоскейлером о числе реплик. Ключ шлюза он выпускает ровно один раз: Idempotency-Key равен metadata.uid, и перезапуск оператора второго ключа не создаёт. Финализатор держит Agent, пока шлюз не подтвердит отзыв, поэтому при недоступном шлюзе удаление ждёт. 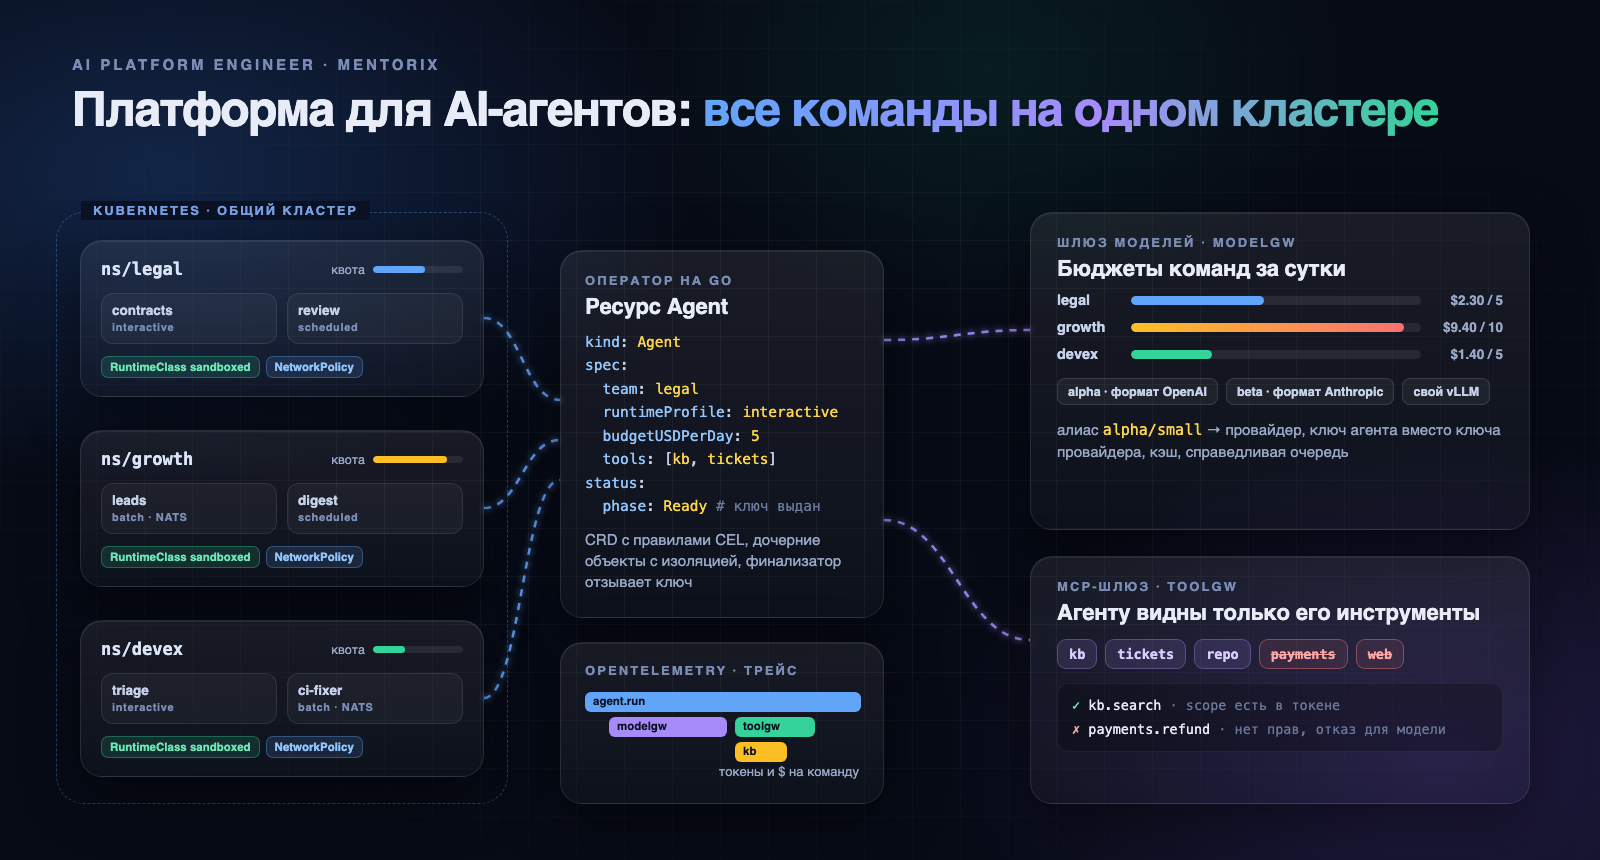
Агенты ходят к провайдерам через **общий шлюз моделей** на нескольких репликах. Бюджеты агента, команды и компании у реплик общие и лежат в Redis: стоимость резервируется на всей цепочке до вызова модели и сверяется с фактом после ответа. Слоты провайдера делятся по весам команд, поэтому команда с большим пакетом не вытесняет остальных. При отказе провайдера запрос не уходит туда, где его класс данных запрещён.
В шлюз агент приходит с **токеном своего пода**. Токен живёт не дольше 10 минут и перестаёт действовать не позже чем через 30 секунд после удаления пода, а ключа провайдера агент вообще не видит. Определения MCP-инструментов закреплены по хешу SHA-256: изменённое описание уходит на ревью, а владелец сервера получает уведомление. Возврат на сумму больше 5 000 ₽ ждёт подтверждения человека и исполняется ровно один раз, сколько бы агент ни повторял вызов.
Кроме оператора и шлюза моделей, вы пишете на Go egress-прокси с политикой на каждого агента, программу допуска пакетных Job, масштабатор воркеров по отставанию очереди, службу обмена токенов aplat-sts, MCP-шлюз toolgw, контроллер выкатки canary с автоматическим откатом, хвостовой семплер трейсов и службу аудита auditd. Работаете с client-go, controller-runtime, cel-go, MCP go-sdk, golang-jwt, pgx, скриптами Lua в Redis и OpenTelemetry.
Задачи на код тоже на Go. В них вы пишете расчёты, по которым платформа принимает решения: делите лимит провайдера взвешенным max-min, считаете каппу Коэна для судьи и тест Макнемара для двух версий агента, ищете точку безубыточности своей модели, раскладываете MIG-профили по картам.
Лабы идут в песочницах трёх видов. В 11 лабораторных поды, Pod Security, сетевые политики, Job и Helm-чарты вы применяете в живом namespace кластера k3s 1.35. Квоты, RBAC, CRD с правилами CEL и политики допуска проверяются на настоящем kube-apiserver 1.35 с etcd и контроллерами внутри лабы. Узлов и kubelet там нет, поэтому поды не стартуют, а API-сервер и контроллеры ведут себя как в кластере. Шлюзы, воркеры и раннеры обращаются к настоящим PostgreSQL, Redis и NATS JetStream.
Моками заменены провайдеры моделей в форматах OpenAI и Anthropic, сервер инференса с API vLLM и MCP-серверы, и все они ломаются по сценарию лабы. GPU представлены фиктивными узлами кластера. gVisor и Kata в песочнице нет: класс sandboxed работает на обычном runc, а механизм RuntimeClass и учёт overhead устроены так же, как с ними.
Проверка запускает решение и смотрит, что оно сделало. Если шлюз списал бюджет дважды, задача не принята, как бы аккуратно ни выглядел код. Чекер изнутри пода исполнителя пробует шесть атак, и решение принимается, только если не прошла ни одна, а скрипт модели при этом отработал. Посреди пакета из 40 прогонов воркер получает SIGKILL, а пакет всё равно должен дойти до конца без потерь и без повторного исполнения. Ваши тесты изоляции на pytest проверяются мутантами: на стенде с подложенной утечкой набор обязан покраснеть.
Весь курс вы строите одну и ту же платформу aplat. С первых уроков на ней работают команды support, research и billing-ops, а в финале подключаются ещё три: legal, growth и devex. Здесь платформа собирается целиком, от онбординга чартом до гейта оценки и canary.
Приёмка проверяет платформу на четырёх сбоях подряд: отказ провайдера, агент в цикле, утечка ключа и падение воркера. На каждый сбой нужен алерт Prometheus, который его заметит, и ранбук, который ваша служба runbookd на Go выполнит по вебхуку Alertmanager. Вердикт выносится по каждому требованию отдельно, так что видно, что именно не прошло.
Вопросы по курсу можно задать поддержке: t.me/mentorix_support
Инженер платформы, DevOps, SRE или бэкенд-разработчик, которому поручили пустить агентов нескольких команд на общий кластер.
Агенты у вас уже работают как обычные поды, каждая команда ходит к провайдеру со своим ключом, и пора ограничить им сеть и доступ к чужим данным.
Отвечаете за действия агента от имени пользователя и за то, что будет, если он уйдёт в цикл или его ключ утечёт.
Решаете, держать ли свою модель на GPU или платить провайдеру, и вам нужен расчёт по профилю нагрузки.
Хотите писать операторы на Go: здесь оператор собирается по шагам, от CRD до двух реплик с выбором лидера.
Модулей: 13, уроков: 70. Задачи с кодом проверяются автоматически.
Стоимость курса: 19990 ₽